主题
智算中心介绍与商务合作说明
智算中心介绍
智流FluxLane已建成新一代智算中心,部署基于 NVIDIA Blackwell Ultra B300 的高性能 GPU 算力集群,并完成 DeepSeek、GLM、Kimi、Qwen、Llama等主流开源大模型的部署与适配。智算中心已通过高并发、高吞吐、长上下文及持续稳定性等多维度自测,并完成多家合作企业的真实业务场景验证,可为企业提供稳定、高效、弹性扩展的大模型推理与 AI 应用基础设施。
TEST SNAPSHOT / 2026-08-27
测试概览
流式测试 · NVIDIA DGX B300 整机
- 测试模型
- 6 款 × 5 轮
- 连通测试
- 30 / 30
- 连通成功率
- 100%
- 可用模型
- 12 款在架
- 最优首字
- 0.78s
- 吐字峰值
- 149 tok/s
- 长上下文测试
- 958K tokens
- 实测上下文
- 958K tokens
实测现场
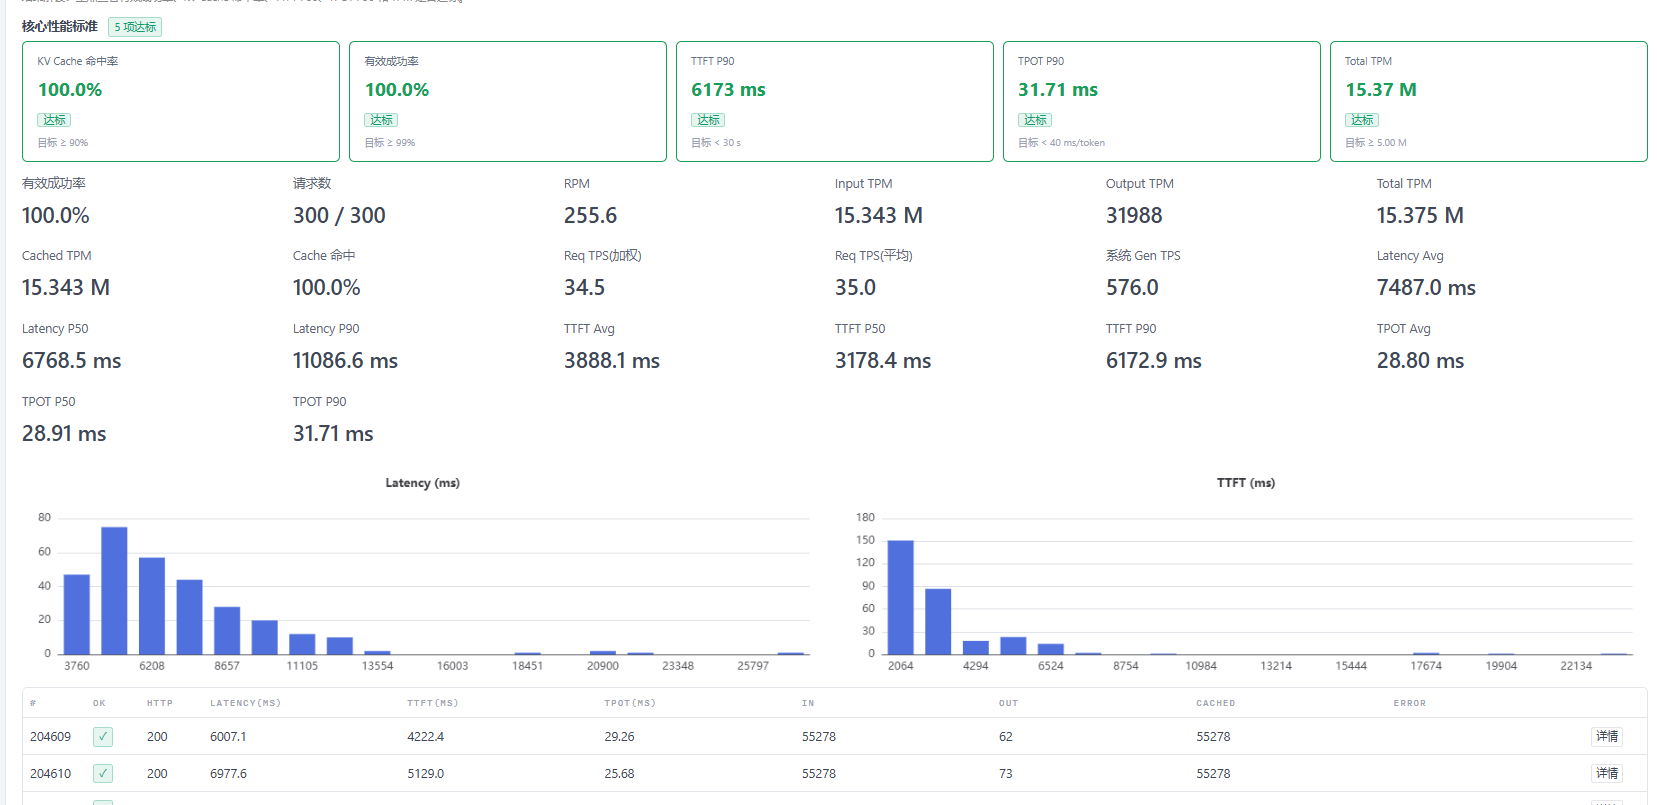
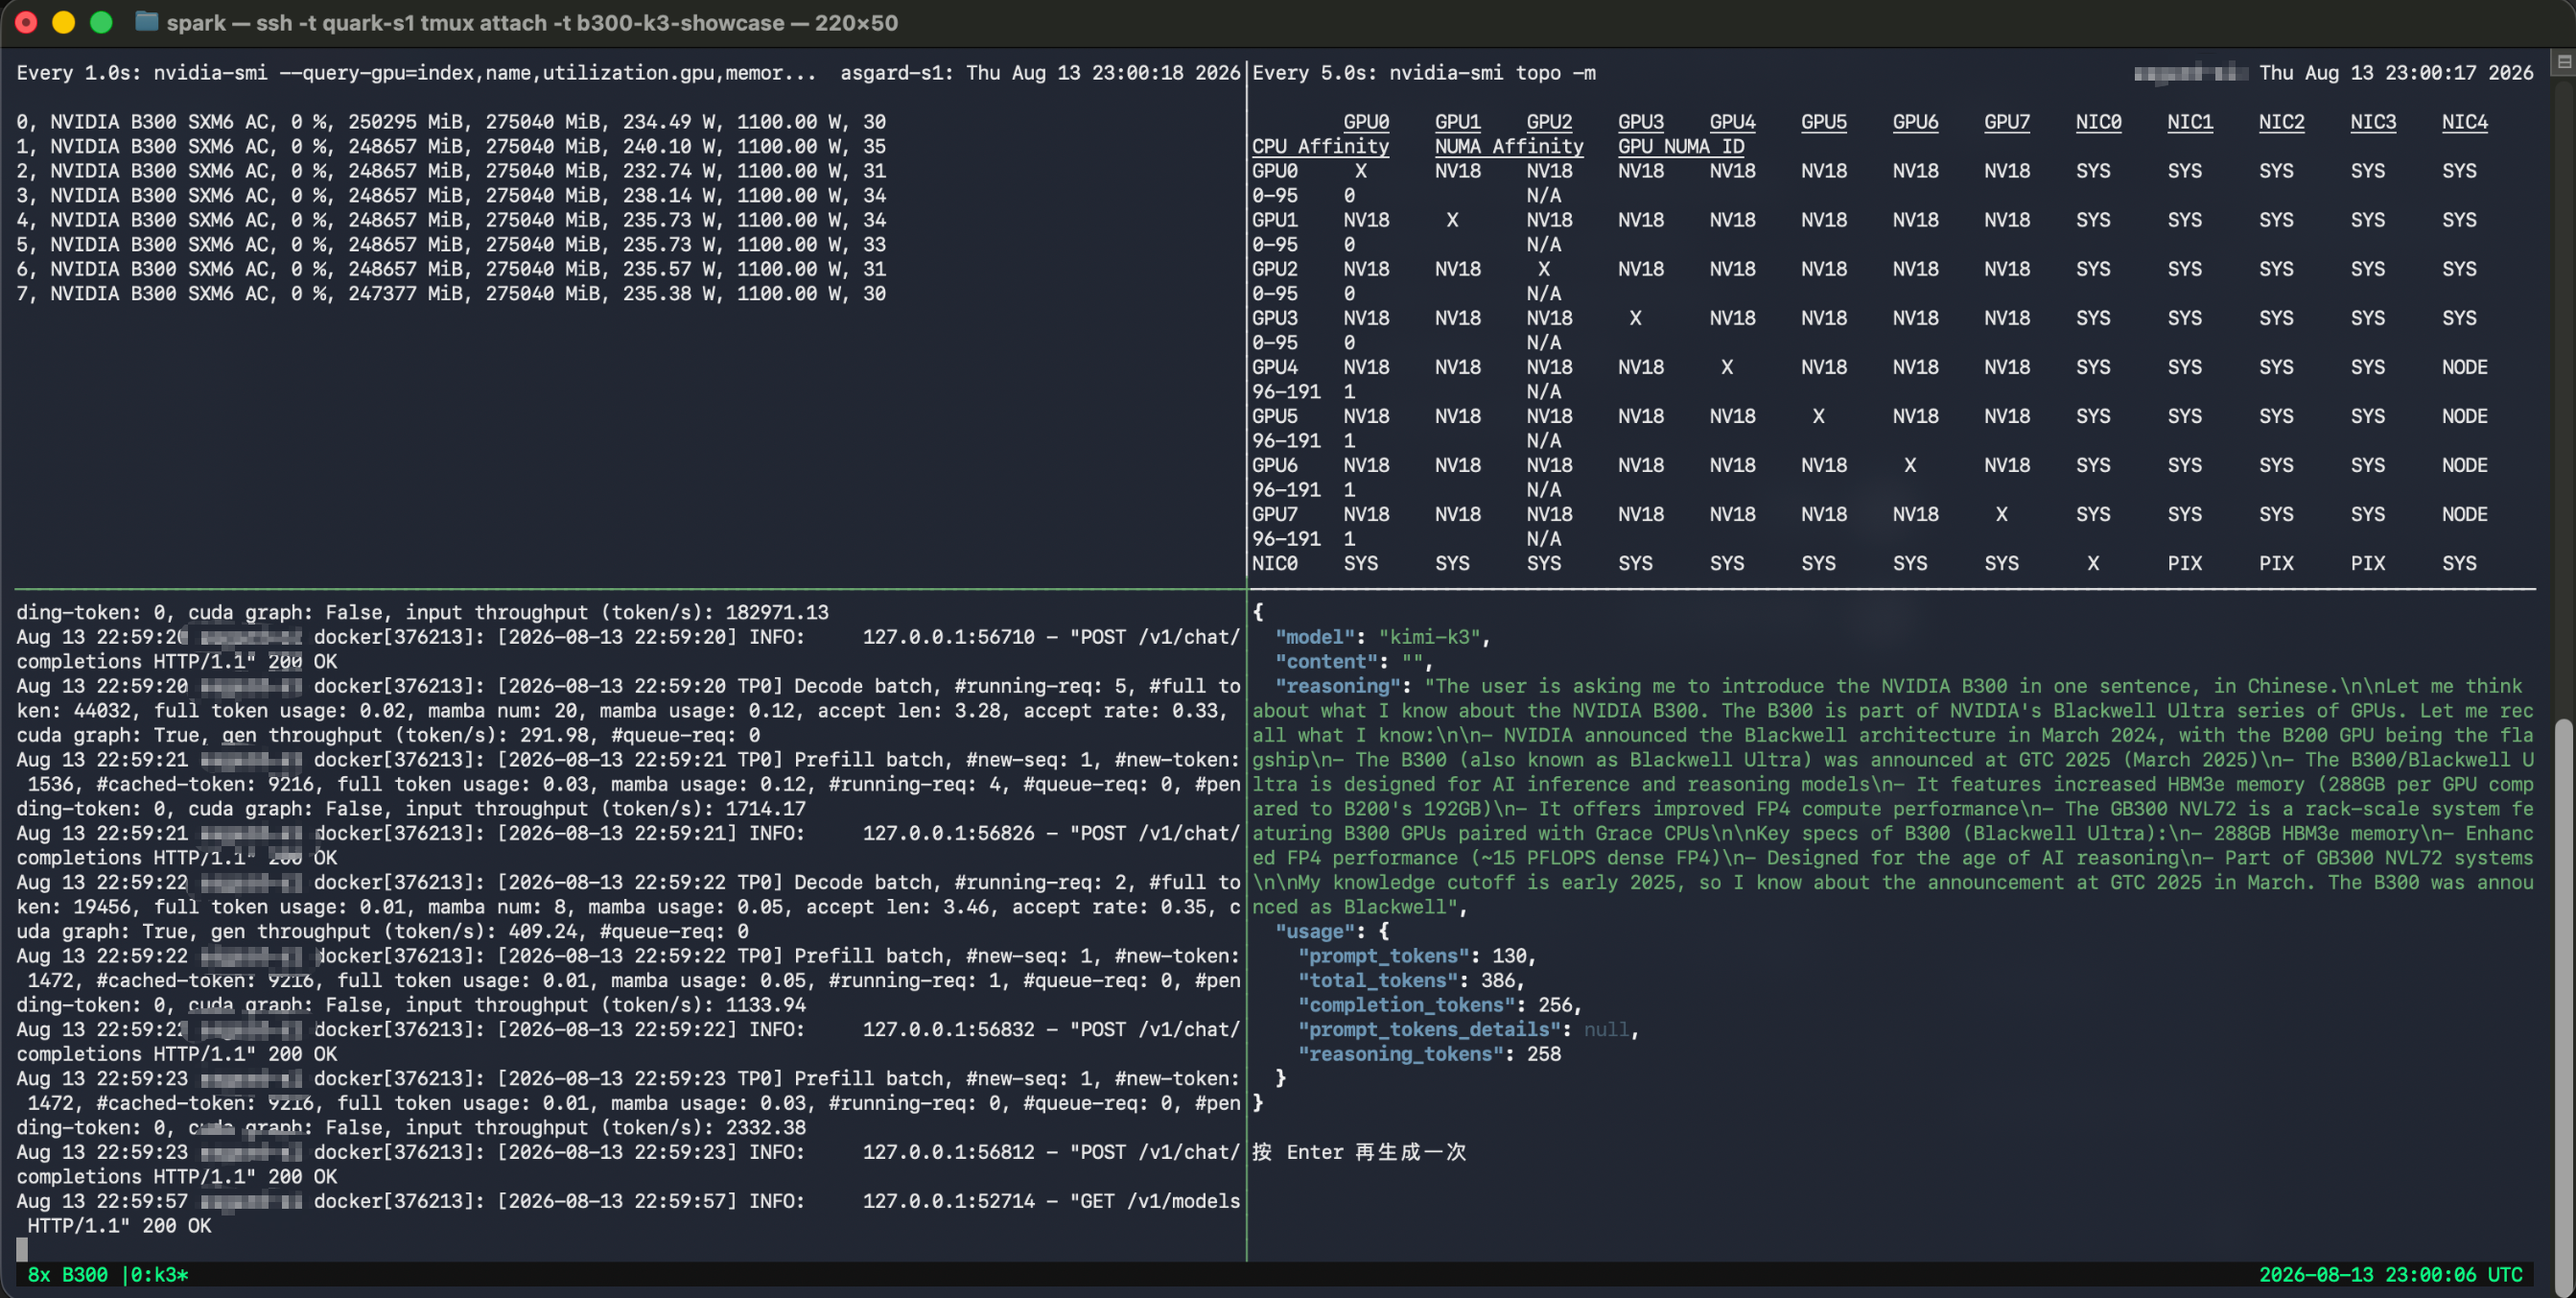
以下为智算中心自测与自部署运行的现场记录,完整报告可在技术评审阶段提供。
01 模型与实测性能
以下为需求量较高的6款模型,全部采用流式方式测试,每款模型测试5轮,并记录最优值与中位数。
FluxLane 当前可用模型以模型广场实时目录为准。
| 模型 ID | 最优首字 | 首字中位 | 吐字峰值 | 吐字中位 | 官网上下文 | 本次实测 |
|---|---|---|---|---|---|---|
| glm-5.2 | 1.28s | 1.73s | 74.9 | 69.2 | 1M | 948K |
| glm-5.3 | 1.98s | 3.86s | 132.6 | 116.0 | 1M | 948K |
| deepseek-v4-flash | 0.78s | 2.89s | 149.4 | 117.8 | 1M | 948K |
| deepseek-v4-pro | 1.58s | 2.27s | 132.2 | 87.6 | 1M | 948K |
| kimi-k3 | 3.84s | 8.90s | 47.3 | 30.4 | 1M | 948K |
| kimi-k3-fast | 6.23s | 7.02s | 68.6 | 32.6 | 1M | 948K |
说明:
- 吐字速率单位为 tok/s,首字耗时即 TTFT;带有星号的数值代表本轮测试最优。
- -fast 为快速响应版本,主要面向高 TPS 等特殊场景。
- 上下文数据已与官网标注逐条核对。本次实测是单次探针实际发送并被正常接收的 prompt_tokens,用于验证上下文长度。
- 完整模型目录请前往智流 FluxLane 模型广场查询,价格与上下文以官网实时标注为准。
峰值不承诺恒定
上表峰值为实测最优值,受当时负载、上下文长度、输出长度影响,不代表任何时刻都能达到。偶发长尾在5%以内属正常现象,请在压测口径中预留余量。需要稳定下限的,请查看下方保底方案。
02 第三方评测与全量跑测
除基础连通性测试外,智流FluxLane 也接受客户指定的标准化评测,并保留完整测试日志。
KVV 测试套件
已完成全量跑测。其中标准 Tools 函数调用与 JSON Schema 结构化输出共 398 / 408 通过,通过率为 97.55%。
完整分项报告可按需提供,也支持客户携带自有测试套件在智流 FluxLane 节点上复跑。
两轮多模态跑测
- MMMU Pro Vision 全量:1,730 / 1,730 样本,100%交付,准确率0.8243。
- OCRBench 全量:同步完成,独立报告可单独提供。
评测报告
以上报告均可作为附件随合同提供,用于甲方内部立项与技术评审。
03 站内价格
发票说明
默认不开具6%增值税专用发票。
以上价格均为不含税价格。如需强制开具6%专用发票,相关税点由客户方补足,请在报价阶段提前说明,以免影响后续结算。
04 支付与合作方式
支付方式
支持以下四种支付渠道:
- 微信
- 支付宝
- 对公转账
小额合作可采用随充随用方式;对公转账更适合大额及长期合作。
合作协议
支持签订模型保真协议,以合同形式约定模型来源与版本一致性。
同时支持对公合同签订,可配合甲方的采购、法务与审计流程。
付款条件
合作一律采用预付款方式。
这是智流 FluxLane 能够提供上述折扣的前提条件,请在项目评估阶段纳入考虑。
05 企业对接-容量如何申报
本节用于确定智流 FluxLane 为客户预留的资源数量,请按照真实业务形态进行申报。容量申报不准确,可能直接影响服务质量与成本。
路径A:随充随打,无需报数
不需要保底资源、可以接受共享池波动的客户,无需申报具体用量,充值后即可使用。
适合验证期、中小流量、波峰不明显的业务。这是大多数客户的起步方式。
路径B:保底 TPM,需要提供四组数据进行定制化排产
如果需要 智流FluxLane 锁定稳定的 TPM 下限,必须提供:
- 日均 TPM 曲线
- TPM 峰值
- 峰值持续时长
- 日 Token 消耗总量
缺少任何一项,智流FluxLane 都无法准确推算所需资源,也无法提供保底承诺。
容量申报注意事项
- 硬并发、RPM、TPM需要分开申报。三者对应的资源约束不同,只提供单一指标无法完成排产。
- 业务曲线比单一峰值更重要。“峰值4000万 TPM,仅持续10分钟”和“持续24小时”属于完全不同的资源方案,成本差异较大。
- 预付款同样适用于保底资源方案。
大额专线说明
例如“24小时持续4000万 TPM”这类大额专线需求,需要 FluxLane 提前预定机房资源,预计3至5个工作日开通。
资源开通后即产生实际占用成本,不接受今天开通、次日停止的临时使用方式。客户申报高容量需求后,需要保证对应的实际用量。
如果无法确保真实用量,建议选择“路径A:小额随充随打”,对双方更合适。
非流式长握手说明
接入前请注意:智流FluxLane 默认链路经过边缘节点防护,边缘读取超时时间为 120秒。如果一次请求从发出到收到第一个字节超过120秒,可能会被边缘节点中断并返回 524。
这通常不是模型本身的问题,而是 CDN 的保护策略。
- 建议默认开启流式响应:stream: true。流式响应在首字返回后会持续产生数据,大多数场景不会触发超时。本次30轮流式测试无一次超时。
- 流式无法解决模型预填充本身超时的问题。上下文极长时,首字之前本来就没有字节可发。实测94.8万token冷启动下,各模型首字耗时46至120秒,其中 kimi-k3 有一次落在128秒,被判定为 524。
- 如果业务经常使用50万token以上的超长上下文,或对超时零容忍,请与 智流FluxLane 签约使用直连专线,绕开 CDN 限制。
智流 FluxLane · 数据实测于 2026-08-27,价格与模型目录以 FluxLane 官网实时标注为准。